从用户真实的问题出发,一页解决一个问题,用原创的证据说话,确认页面能被收录,再用搜索数据决定下一步。
- 学习结果
- 整理出一份来自真实问题的选题清单,写出一篇符合要求的内容,并会用 Search Console 判断问题出在收录、选题还是页面本身。
- 时长
- 2-3 小时
- 难度
- 经验分享
- 核验
- 未核验
正文
对独立开发者来说,搜索带来的流量有一个很大的好处:它是持续的。发布平台的曝光只有一两天,而一篇真正解决问题的文章,可能在之后几年里每天都有人通过搜索找到它。
但这类流量来得慢,也没有捷径。Google 在它的官方指南里反复强调的一点是:内容首先要对人有帮助,而不是为搜索引擎而写。这篇讲怎样把用户的真实问题,变成能长期带来访问的内容。
选题:从用户的真实问题出发
最好的选题来自用户真实的问题:客服邮件里反复被问到的、社区里有人求助的、访谈时用户提到的。比如“CSV 用 Excel 打开中文乱码怎么办”,比“数据处理的未来”更接近人们实际会搜索的内容。
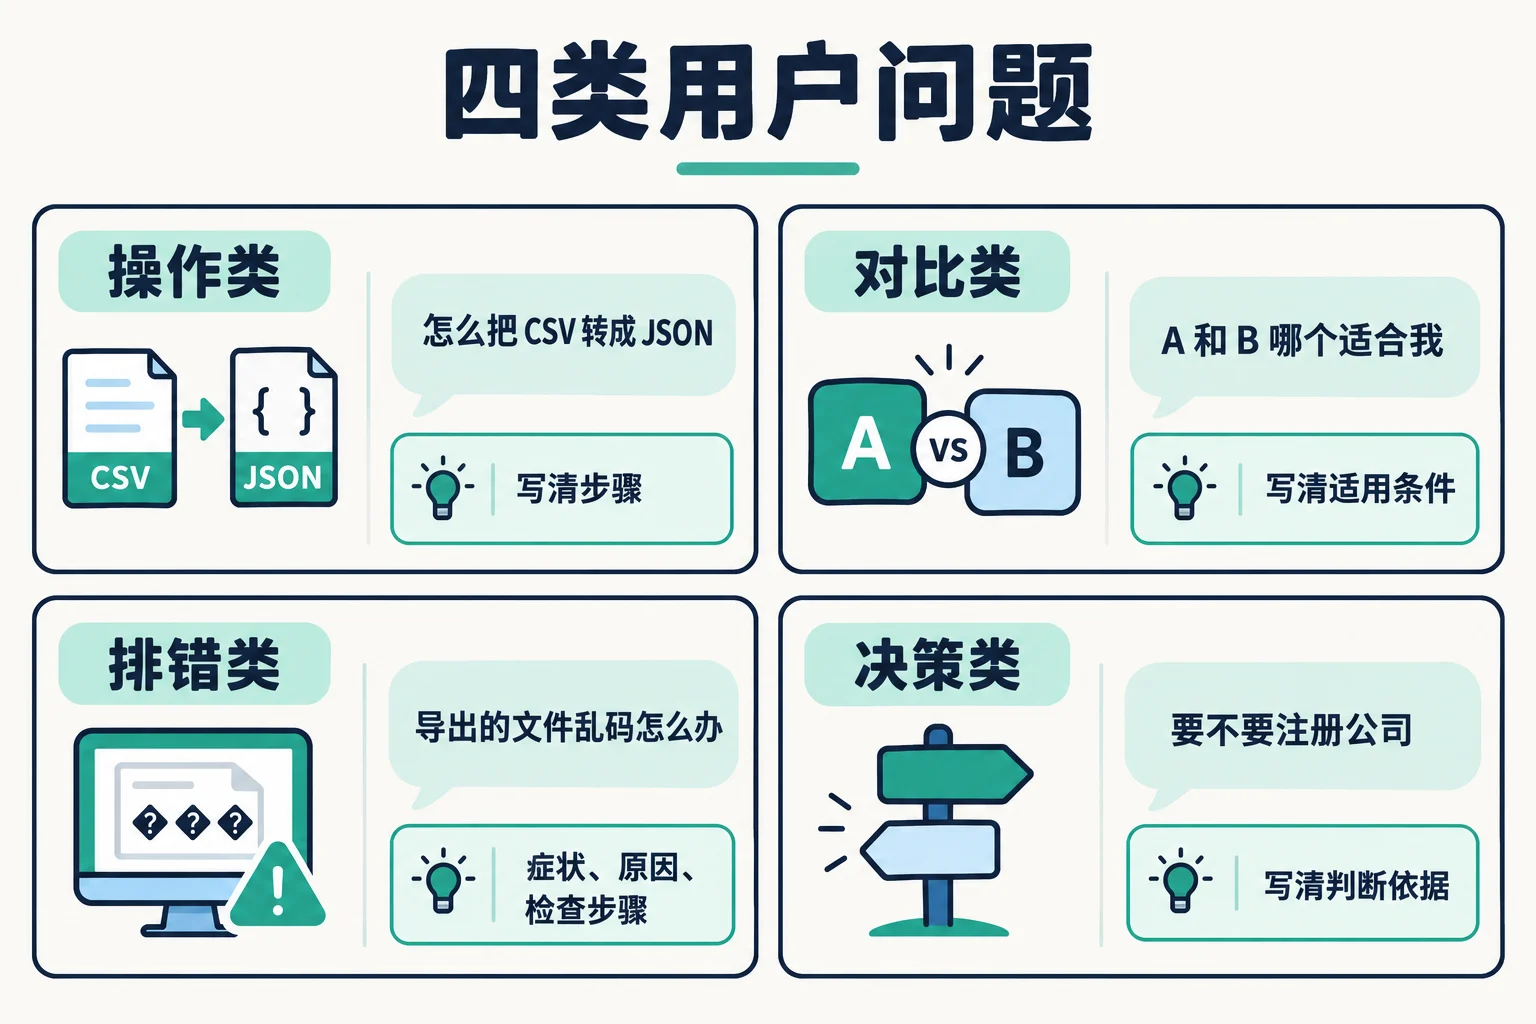
问题大致可以分成四类,各自适合不同的写法:
- 操作类:“怎么把 CSV 转成 JSON”,写清楚步骤。
- 对比类:“A 工具和 B 工具哪个适合我”,写清楚适用条件和差别。
- 排错类:“导出的文件乱码怎么办”,写清楚症状、原因和检查步骤。
- 决策类:“个人开发者要不要注册公司”,写清楚判断依据。
优先写你能提供真实样例和可靠来源的问题。不要为了覆盖更多关键词,批量生成一堆内容相似的页面。
一页解决一个主要问题
每一页围绕一个主要问题。排错类文章先讲症状和检查步骤,对比类文章先讲适用条件和关键差别。标题和摘要要准确反映正文内容。
不要标题写“一步解决”,正文却只有产品介绍;也不要为了重复关键词,写出读起来很别扭的句子。读者能不能完成他要做的事,比关键词出现了几次重要得多。
用原创的证据
让文章可信、可以核对:给出输入的样例、操作的截图、实际的结果,以及失败的情况。引用原始的官方文档,并注明适用的版本。
涉及技术标准、平台政策的内容,区分“标准是怎么规定的”和“我自己的经验”。不要把同行的文章改几个词当成自己的,也不要把无法核实的数据包装成研究结论。
确认页面能被找到和收录
文章写得再好,搜索引擎找不到、不收录,也不会有流量。有几个容易混淆的概念:
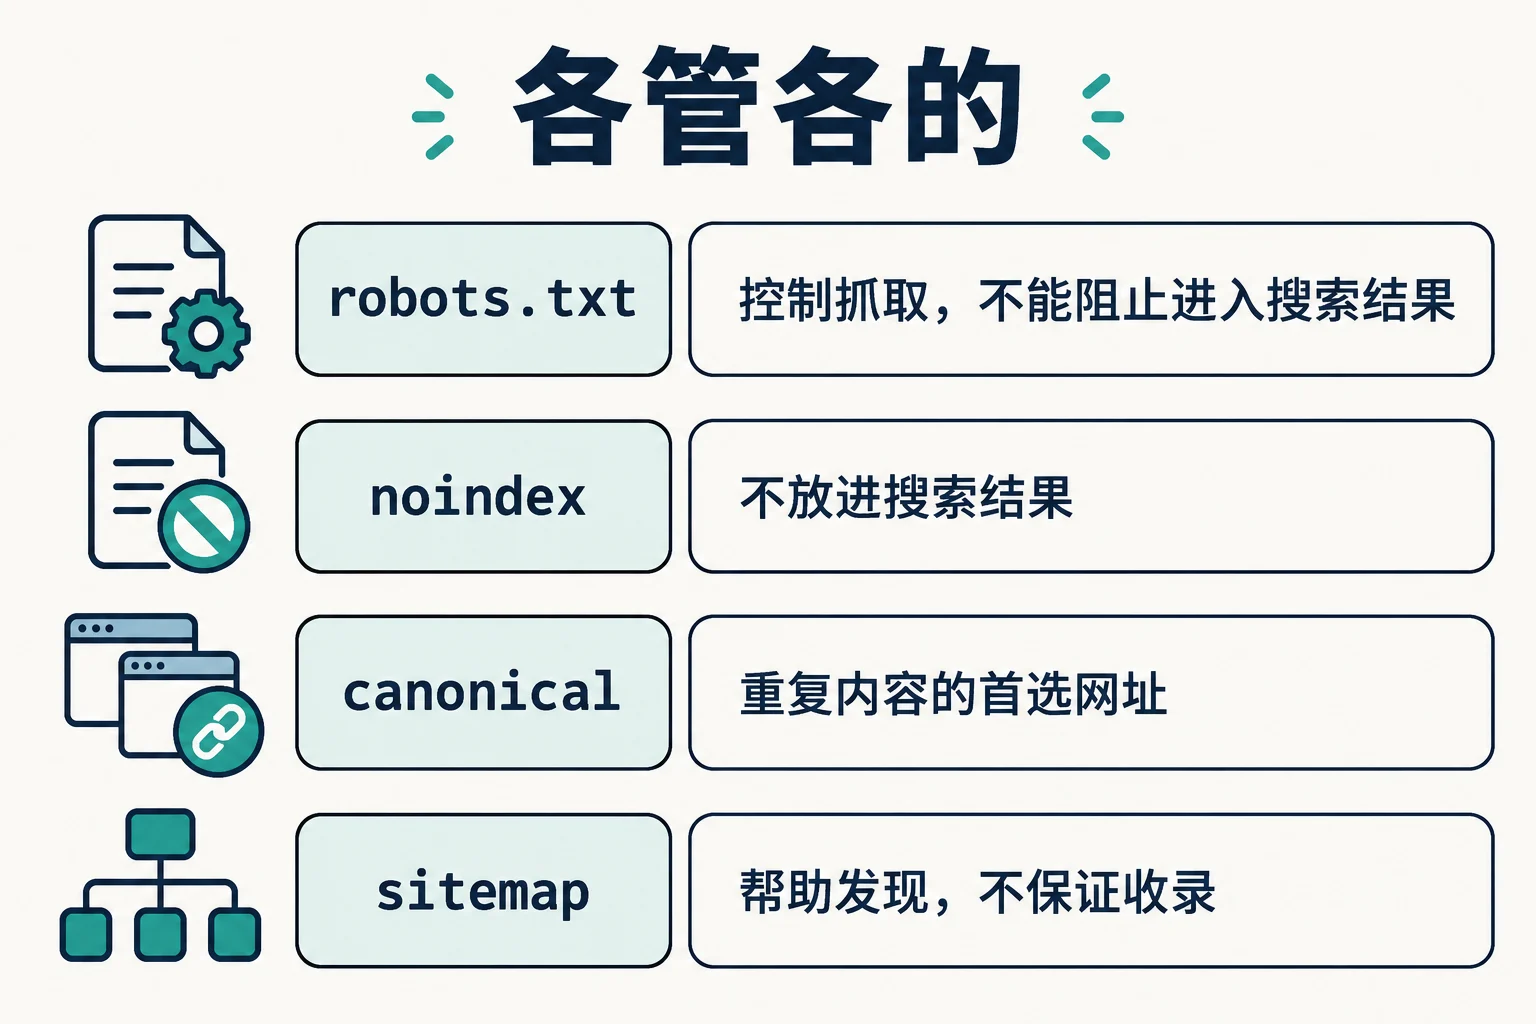
- robots.txt:告诉搜索引擎的抓取工具哪些地址不要抓取。Google 的文档特别说明,它不是用来阻止网页出现在 Google 搜索结果里的手段;要做到这一点,应该用 noindex 或者密码保护。
- noindex:告诉搜索引擎这一页不要放进搜索结果。
- canonical:内容重复的多个网址中,告诉搜索引擎哪个是首选版本。
- sitemap:帮搜索引擎发现你的页面。Google 说明,提交 sitemap 并不保证里面的每个页面都会被抓取和收录。
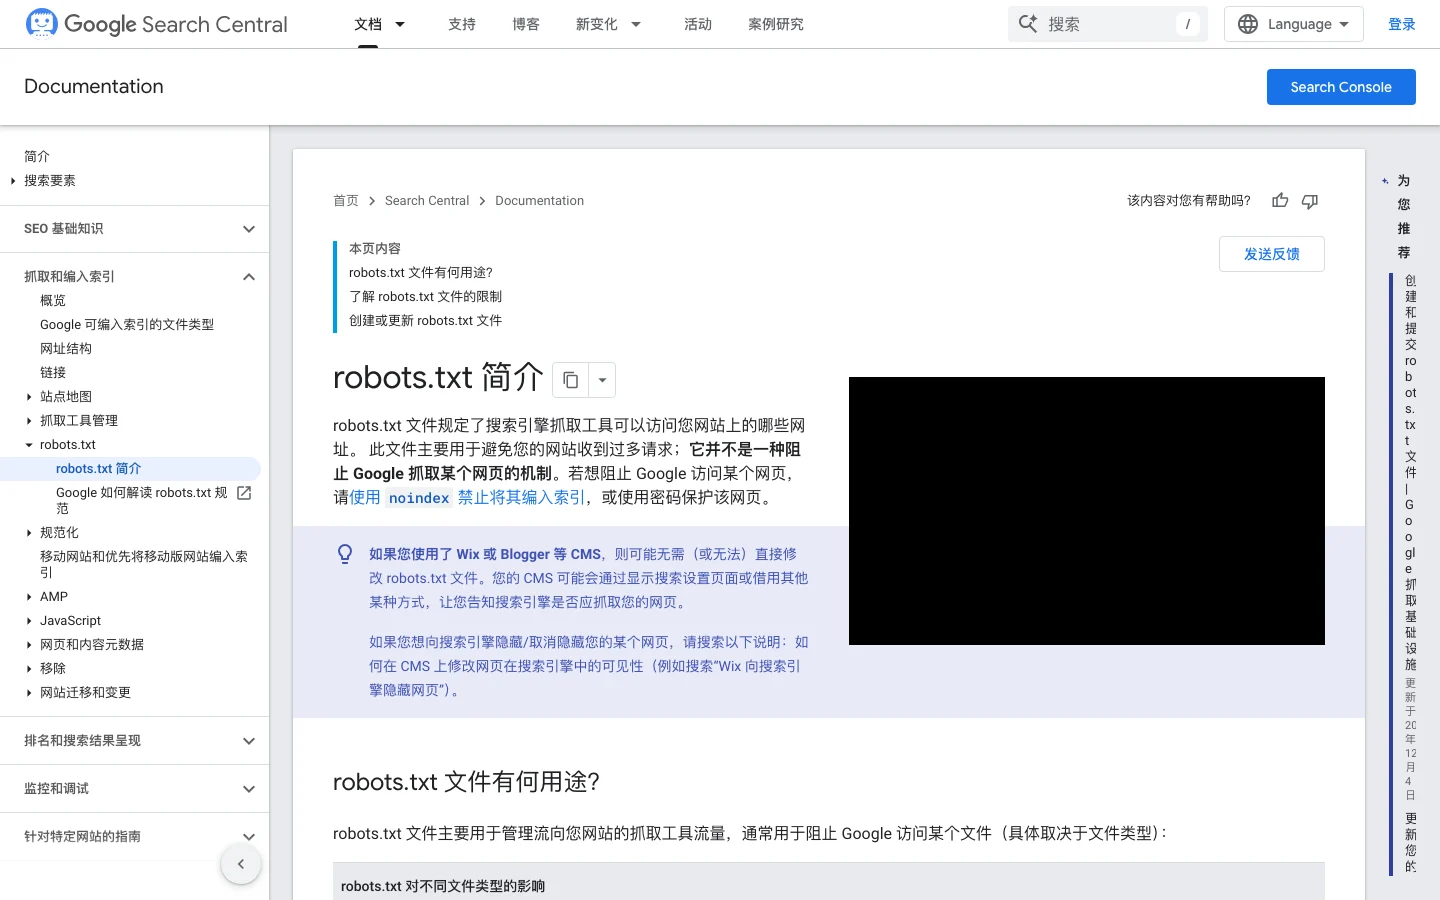
图:Google 搜索中心“robots.txt 简介”官方文档页面截图,截取于 2026-10-24,内容以官方当前页面为准。
发布后,在 Google Search Console 里检查页面是否已经被收录;没有收录的话,看它给出的原因。
内链:帮读者继续完成任务
在文章里链接到相关的内容,帮读者继续往下走。比如乱码排错的文章,可以链接到编码原理的说明和转换工具。链接文字要说明目标页面是什么,不要每段都放一个推广链接。
相似的主题,优先完善已有的页面,而不是再写一篇。更新内容时保留原来的网址;只有真正重新核对过来源,才更新核对日期。
用数据决定下一步
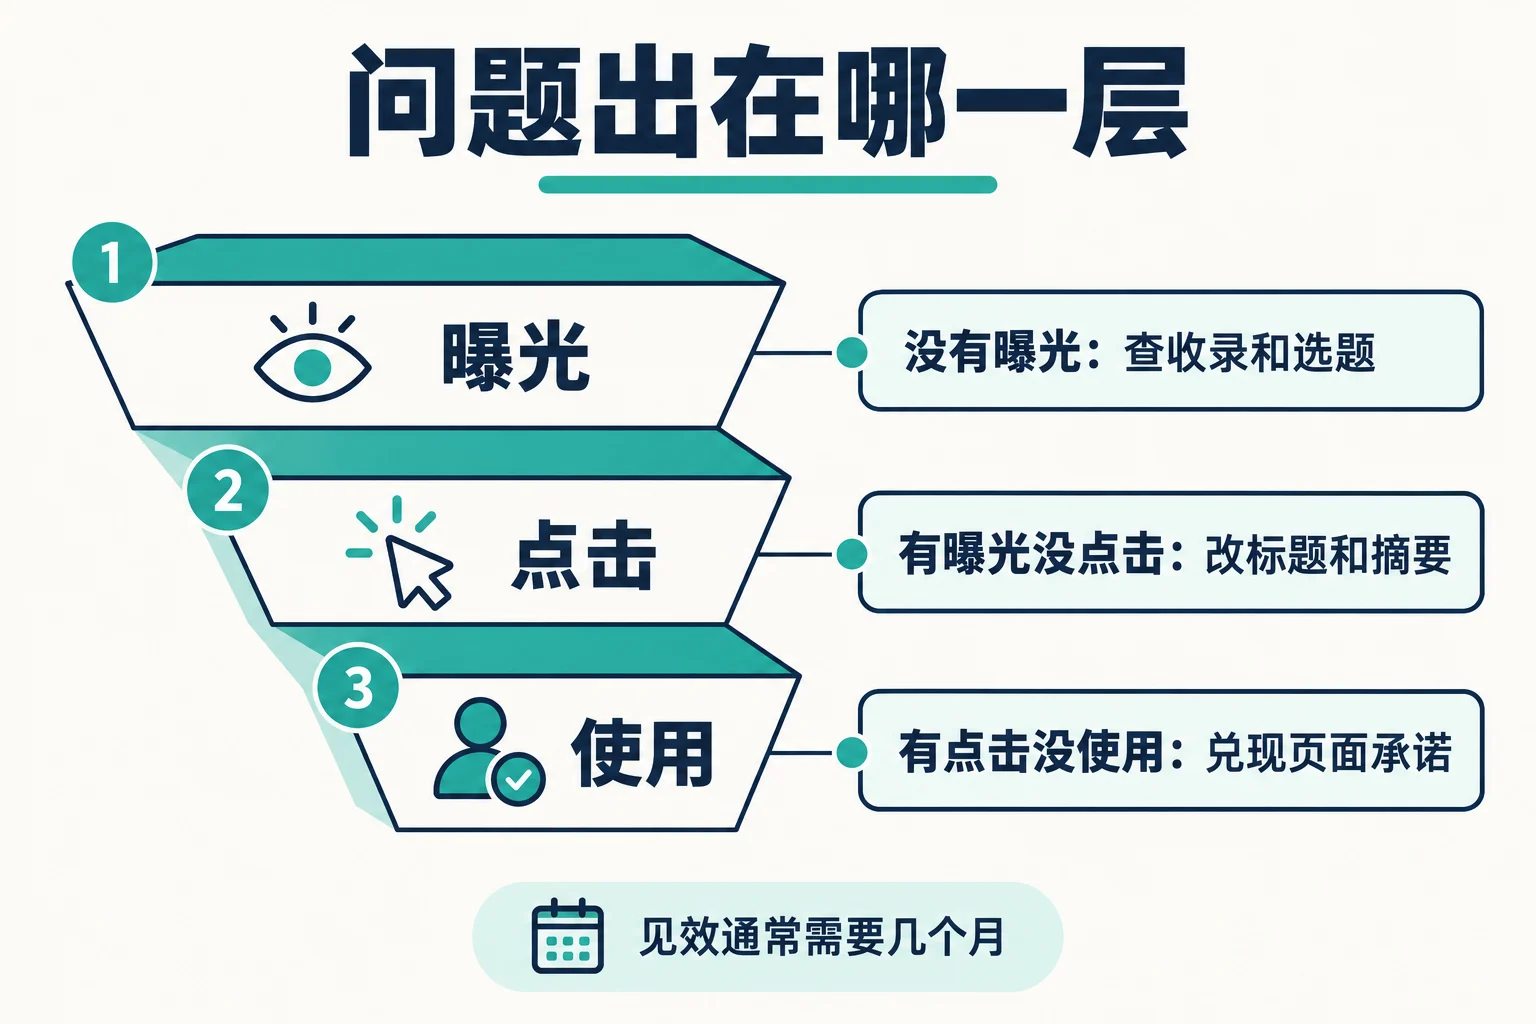
Search Console 显示的是搜索曝光、点击和用户搜索的关键词;站内统计显示的是用户在你的网站上做了什么。两者是不同的数据,要结合着看:
- 没有曝光:先检查页面是否被收录,再看这个选题是否真的有人搜索。
- 有曝光,没有点击:检查标题和摘要是否准确、有吸引力。
- 有点击,没有人使用:检查页面是否兑现了标题的承诺。
搜索排名受很多因素影响,内容见效通常需要几个月。没有人能保证“写四篇文章流量就会增长”。
学习步骤
- 从客服邮件、社区和访谈中收集 20 个用户真实问过的问题。
- 把问题分成操作、对比、排错、决策四类,标出你能提供真实样例的。
- 选一个问题,写一篇一页解决一个问题的文章,包含样例、截图和失败情况。
- 检查页面没有被 robots.txt 或 noindex 意外屏蔽,网址只有一个首选版本。
- 在 Search Console 提交 sitemap,并检查这一页的收录状态。
- 发布一个月后,按曝光、点击、使用三层判断问题出在哪里。
场景拆解
一篇排错文章的三个月
小许的 CSV 转换工具,经常有用户问同一个问题:用 Excel 打开导出的 CSV,中文是乱码。
- 选题:他在客服邮件里找到 7 封问这个问题的,于是写了“CSV 用 Excel 打开中文乱码的原因和三种解决方法”。
- 证据:文章里放了乱码和正常显示的对比截图,解释了编码的原因,给出三种方法的实际操作步骤,并说明其中一种方法在旧版本 Excel 里不适用。
- 检查收录:发布一周后,Search Console 显示这一页“已发现,尚未编入索引”。他检查后发现,站点的 robots.txt 里有一条旧规则屏蔽了整个
/blog/目录。删掉这条规则之后,页面很快被收录。 - 观察数据:第二个月,这页每天有几十次曝光,但点击很少。他发现标题在搜索结果里被截断,看不到“解决方法”这几个字,于是改短了标题。
- 第三个月:点击稳定增长,其中一部分读者点击了文中的工具链接,开始使用他的工具。
如果他没有去 Search Console 检查收录,可能会以为“这个选题没人搜”,然后放弃这篇文章。
补充材料
思维导图、练习、清单和参考资料可按需展开。
01 思维导图和离线文件
适合读完后下载到自己的知识库里继续整理。
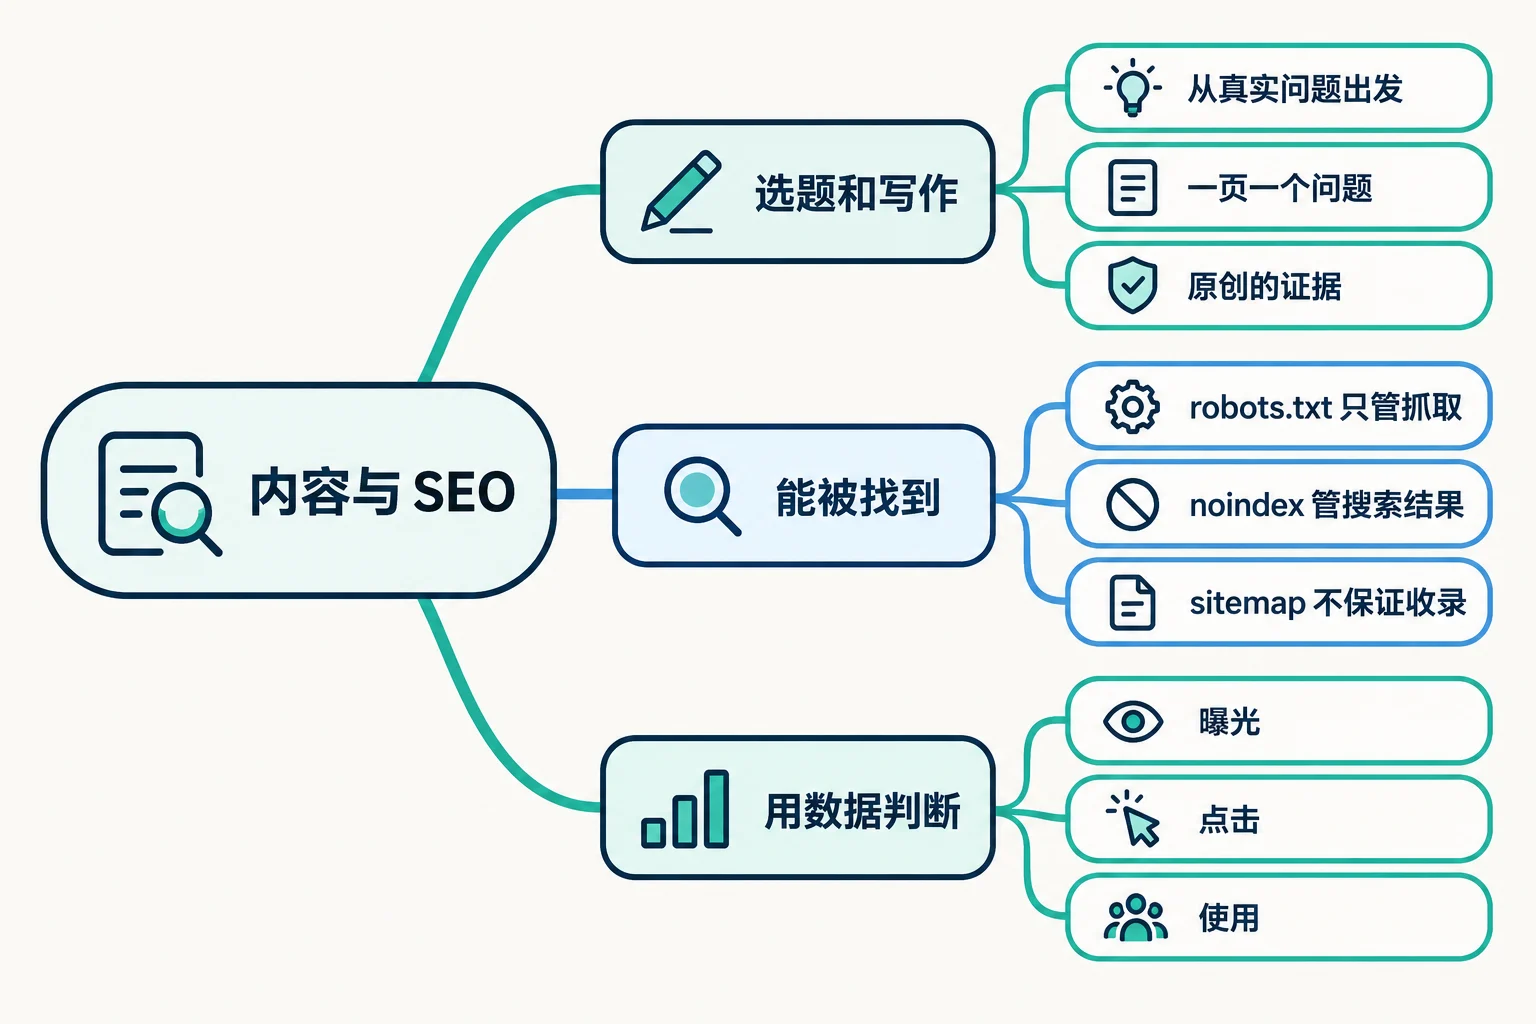
选题和写作
- 从用户真实问题出发
- 操作、对比、排错、决策
- 一页解决一个问题
- 原创的证据和失败情况
能被找到
- robots.txt 只管抓取
- noindex 管搜索结果
- canonical 指定首选网址
- sitemap 不保证收录
用数据判断
- 没有曝光:查收录和选题
- 有曝光没点击:改标题摘要
- 有点击没使用:兑现承诺
- 见效需要几个月
02 实践练习
根据文章内容记录自己的判断与依据。
写一篇来自真实问题的文章
从用户的问题出发,完成一篇文章,并检查它能否被收录。
准备材料
- 客服邮件、社区帖子或访谈记录。
- Google Search Console 账号,并已验证你的网站。
练习步骤
01 / 整理选题
时间: 40 分钟
操作:
- 收集 20 个用户真实问过的问题,记下出处。
- 按四类分类,选出你能提供真实样例的一个。
产出: 一份选题清单。
检查: 每个问题都有真实的出处,不是凭空想出来的关键词。
02 / 写文章
时间: 90 分钟
操作:
- 按问题类型选择写法,加入样例、截图和失败情况。
- 核对标题和摘要是否准确反映正文。
产出: 一篇文章。
检查: 读者看完能完成他要做的事。
03 / 检查收录
时间: 30 分钟
操作:
- 检查 robots.txt、noindex 和 canonical 的设置。
- 在 Search Console 里查看这一页的收录状态。
产出: 一份收录检查记录。
检查: 知道这一页现在是否已被收录,如果没有,原因是什么。
完成检查
- 选题来自用户真实的问题。
- 文章有原创的证据,一页解决一个问题。
- 能用数据判断问题出在收录、选题还是页面。
03 清单、模板和关键词
用于项目记录和自查。
选题记录
| 问题原文 | 出处 | 类型 | 能否提供真实样例 | 已有相关页面 | 优先级 |
|---|---|---|---|---|---|
发布前检查
- 标题和摘要准确反映正文
- 一页围绕一个主要问题
- 有样例、截图和失败情况
- 引用了官方来源并注明版本
- 没有被 robots.txt 或 noindex 意外屏蔽
- 只有一个首选网址
- 链接文字说明了目标页面
关键概念
- 搜索意图:用户搜索时真正想完成的事
- robots.txt:控制抓取,不能阻止页面进入搜索结果
- noindex:让页面不出现在搜索结果里
- canonical:重复内容的首选网址
- sitemap:帮助发现页面,不保证收录
- 曝光、点击、使用:三层判断问题在哪
容易误判
- 从关键词工具而不是用户问题出发选题
- 批量生成内容相似的页面
- 标题承诺的和正文内容不符
- 用 robots.txt 阻止页面出现在搜索结果里
- 以为提交了 sitemap 就一定会被收录
- 只润色不核对,却更新了日期
04 工具和参考资料
本篇涉及的工具和参考链接。
可参考工具
- Google Search Console
- Bing Webmaster Tools
- Plausible
- Ahrefs Webmaster Tools